Den nye kernefortælling er et kerne brand kontekst dokument skrevet til robotterne
Det nye hedder brand context optimization: at få AI-modellerne til at beskrive jer korrekt og on brand. Det kræver, at kernefortællingen skrives om til en tekstfil, maskiner kan læse. Her er skabelonen.


Kernefortællingen har fået en ny læser
Den hedder ChatGPT, Gemini eller Claude, og den læser ikke jeres brandbog med farvekoder og logoer. Den læser tekst. Et brand kontekst dokument er en ren tekstfil, som fastlægger hvem I er, hvad I vil kendes for, hvordan I lyder, og hvilke formuleringer der er godkendt. Filen fodres til virksomhedens egne chatbots, copilots og prompt biblioteker. Den er også facitliste for alt, hvad I skriver ud af huset.
Derfor er det vigtigt
Når nogen beder en sprogmodel anbefale en leverandør, får de en shortlist på to til fem navne. Der er ingen side to at scrolle ned til. Står I ikke på listen, findes I ikke for den kunde.
Det sker tidligere, end de fleste tror. Sarah Evans fra Zen Media kalder det "the before layer": Maskinen har kogt flere års omtale ned til et par sætninger, sat jer i en kategori og valgt, hvilke konkurrenter I nævnes sammen med. Alt det er sket, før et menneske har klikket på noget. Når kunden endelig ringer, er spørgsmålene og indvendingerne allerede formet.
Og plads på listen kan ikke købes. Der findes ingen annoncer i svaret fra en sprogmodel. Den eneste vej ind er, at modellen har forstået jer rigtigt.
Strategien hedder brand context optimization
Målet er at fremstå korrekt og on brand i AI-modellerne. Altså at modellen nævner jer i de rigtige sammenhænge, med de rigtige egenskaber, i en tone I kan kende jer selv i.
Det er noget andet end søgemaskineoptimering. SEO skal trække brugeren ind på hjemmesiden. Brand context optimization skal sikre, at modellen beskriver jer rigtigt i sit eget svar, også når brugeren aldrig klikker videre.
Mekanikken er enkel. En sprogmodel opfatter et brand som et navn med en række egenskaber hæftet på. Jo oftere navnet står tæt på de samme begreber på tværs af nettet, jo fastere sidder koblingen. Kopp bruger Notion som eksempel: Navnet optræder igen og igen ved siden af ord som samarbejde, noter og produktivitet, og derfor anbefaler modellerne Notion, når nogen spørger efter et produktivitetsværktøj.
Kontekstdokumentet er strategiens arbejdsredskab. Det er her, I beslutter, hvilke egenskaber der skal hæftes på navnet. Resten af arbejdet består i at få de samme ord til at stå alle de steder, modellerne læser.
Fra historie til instruks
Kernefortællingen blev skrevet til medarbejdere og hang på væggen. Tone of voice-guiden blev skrevet til bureauet. Kontekstdokumentet samler begge dele i ét format, som en maskine kan bruge uden at gætte. Den gamle kernefortælling var en historie. Den nye er en instruks.
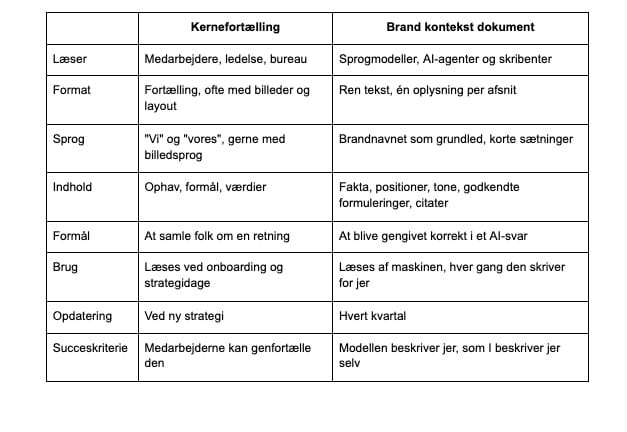
Samme brand, to læsere. Kernefortællingen samler medarbejderne om en retning. Kontekstdokumentet sørger for, at sprogmodellen gengiver virksomheden korrekt.
Tre regler for teksten
Her er tre skriveregler, som gælder både dokumentet og alt andet, I udgiver om jer selv.
Brug brandnavnet som grundled. "Vi" og "vores" tvinger modellen til at regne ud, hvem der tales om, og så laver den fejl.
Skriv korte sætninger med grundled, udsagnsled og genstandsled. Jo tættere navnet står på egenskaben, jo stærkere bliver koblingen.
Én oplysning per afsnit, højst 400 tegn. Modellerne klipper tekst i stumper, og hver stump skal kunne stå alene.
Her skal dokumentet ligge
Fire steder. Og kun ét af dem er en mappe.
Som masterfil ét sted. Én tekstfil på fællesdrevet eller intranettet, med én navngiven ejer og en dato øverst. Ingen kopier i folks egne mapper. Findes der to versioner, har I allerede den uenighed, dokumentet skulle fjerne.
Inde i jeres AI-værktøjer. Filen lægges ind som fast instruks eller vidensgrundlag i alle de værktøjer, der skriver på virksomhedens vegne: kundeservicebotten, Copilot-agenterne, kommunikationsafdelingens projekter i ChatGPT eller Claude, promptbiblioteket. Det er her, den gør mest gavn fra dag ét, fordi maskinen læser den før hvert eneste svar.
Hos de mennesker, der skriver for jer. Nye medarbejdere får den ved onboarding. Bureauet, freelancerne og pressefolkene får den sammen med briefet.
Ude på nettet, men i en anden form. ChatGPT og Gemini læser aldrig jeres fællesdrev. De læser hjemmesiden, Wikipedia, LinkedIn og pressen. Derfor skal dokumentets faktadel stå ordret de steder: sætningen om hvem I er, de tre positioner, nøgletallene og citaterne. Start med Om os-siden og presserummet, og ret derefter virksomhedsprofilerne på LinkedIn, i brancheregistre og på Wikipedia til, så de siger det samme. Tonereglerne og listen over forbudte formuleringer bliver indenfor.
Masterfilen styrer altså jeres egne robotter direkte. De andres robotter styrer I kun ved at gentage den offentligt.
Hvis I ikke har skrevet det
Så skriver maskinen det selv. Den stykker en beskrivelse sammen af det, den finder: en gammel pressemeddelelse, en tråd på Reddit, en konkurrents sammenligningsside. Resultatet leveres i samme sikre tonefald som alt andet, og kunden kan ikke se forskel på fakta og gætværk.
Tre ting går typisk galt.
I havner i den forkerte kategori. Modellen placerer jer ved siden af konkurrenter, I ikke selv ville vælge, eller glemmer jer helt, når nogen spørger efter det, I faktisk er bedst til.
Forældede oplysninger lever videre. Den direktør, der stoppede for tre år siden, og det produkt, I har lukket, står stadig i svaret, fordi ingen har givet modellen noget nyere at holde sig til.
Jeres egne AI-værktøjer taler i munden på hinanden. Kundeservicebotten, salgsafdelingens copilot og kommunikationsafdelingens promptbibliotek beskriver virksomheden på hver sin måde. Hver afvigelse er en ny modstridende kilde, som de eksterne modeller siden samler op.
Den sidste er den dyreste. Modellerne belønner brands, der beskrives ens overalt. Uden et fælles dokument producerer I selv den uenighed, der holder jer ude af shortlisten.
Dokumentet gør det ikke alene
Modellerne stoler mest på det, andre siger om jer. Står der ét på hjemmesiden, noget andet på Wikipedia og noget tredje i fagpressen, taber I. Kontekstdokumentet er kun noget værd, hvis det samme står alle andre steder.
Kommunikationsfolk har i tyve år klaget over, at ingen læste kernefortællingen. Nu bliver den læst hver gang, ordret, af en læser uden sans for ironi. Kan I ikke beskrive jer selv i én sætning, som en maskine kan gengive korrekt, gør maskinen det for jer.
FAKTABOKS Skabelon: Brand kontekst dokument
Gem som ren tekst. Opdater hvert kvartal.
- Formål Dette dokument er [brandnavn]s reference for fakta, tone og sprog. AI-værktøjer og skribenter skal bruge det som første kilde.
- Brandet i én sætning [Brandnavn] hjælper [målgruppe] med [problem] ved at [metode eller resultat].
- Tre positioner Position 1: [det I vil kendes for]. To sætninger om hvorfor. Én sætning AI altid skal kunne sige. Position 2: [metode, data eller faglighed]. Samme opbygning. Position 3: [holdning eller plads i branchen]. Samme opbygning.
- Tone Gør: Svar først, forklar bagefter. Brug tal og navngivne kilder. Skriv brandnavnet frem for "vi". Undgå: Buzzwords og superlativer. Lange indledninger. Henvisninger som "som nævnt ovenfor".
- Godkendte formuleringer Sådan siger vi det: [to til fire sætninger I gerne vil genkendes på]. Sådan siger vi det aldrig: [to til fire sætninger der er forbudt].
- Fagordbog [De fem til ti begreber, der altid bruges ens. Ingen synonymer.]
- Fakta Grundlagt [år]. Hovedsæde i [by]. Antal ansatte [tal]. Ydelser [liste]. Ét faktum per linje.
- Citater "[Godkendt citat]." [Navn], [fuld titel].
- Årets faste nedslag [Kampagner, rapporter og begivenheder per kvartal.]
- Ejer og dato [Hvem vedligeholder dokumentet, og hvornår er det sidst rettet.]
LÆS MERE
Sarah Evans: nyhedsbrevet PR@ctical
Olaf Kopp: What is brand context optimization for GEO?
Olaf Kopp: Brand Context Optimization, a practical step-by-step guide


