Stjæl vores værktøj til GEO analyse eller byg dit eget
Vi har bygget vores eget værktøj til GEO i Lovable sammen med PRception. Det viser, hvordan ChatGPT, Claude, Gemini og Perplexity omtaler din organisation. Stjæl opskriften, eller byg videre.


Vi ville vide, hvad ChatGPT, Claude, Gemini og Perplexity siger om Copenhagen Review of Communication, når ingen har bedt dem om det. Så byggede vi et lille værktøj i Lovable, der kan finde ud af det. Vi har udviklet det sammen med Dennis Bylov Dalgaard fra PRception. Her er beskrivelsen. Stjæl den, eller byg videre.
Der findes betalte platforme til GEO. Nogle af dem er gode. Men vi ville se maskinrummet selv, og vi ville kunne stille de spørgsmål, vores egne læsere faktisk stiller. Det kan man, når man selv har bygget tingen.
Hvad værktøjet gør
Det måler, hvordan en organisation bliver opfattet af de store sprogmodeller. Bliver den nævnt? Linker modellen til den? Er gengivelsen rigtig? Og hvem bliver nævnt i stedet?
Man logger ind med sin e-mail og får et link, der virker én gang. Så beskriver man virksomheden: navn, domæne, kategori, de nærmeste konkurrenter og en kort beskrivelse af, hvad man laver.
Ud fra det laver værktøjet seks standardspørgsmål. Fire af dem nævner ikke virksomhedens navn. De tester spontan synlighed: et bredt kategorispørgsmål, samme spørgsmål formuleret anderledes, et spørgsmål om netop den niche, man selv mener at eje, og et spørgsmål om alternativer til en navngiven konkurrent. De sidste to nævner navnet direkte. Det ene er en sammenligning med konkurrenten, det andet et rent faktatjek.
Spørgsmålene sendes via API til ChatGPT, Claude, Gemini og Perplexity. Modellerne kan køres med og uden søgning på nettet. Den forskel viser sig at være vigtig.
For hvert svar registrerer værktøjet, om virksomheden blev nævnt, om eget site blev citeret med link, hvilken placering den fik i svaret, hvilke sider modellen læste, og hvem der ellers blev nævnt. Det hele samles i en rapport med SWOT, scorecard, trafiklys pr. spørgsmål, en liste over de mest brugte kilder og forslag til næste skridt.
Man kan skrive sine egne spørgsmål, stille et enkelt spørgsmål til alle motorer på én gang, teste om AI overhovedet kan læse ens hjemmeside, og lave en genmåling, når man har ændret noget. Almindelige brugere har 300 kørsler om måneden, administratorer 3000.
Indgangen til værktøjet. Ingen adgangskode, bare et link i indbakken, der virker én gang.
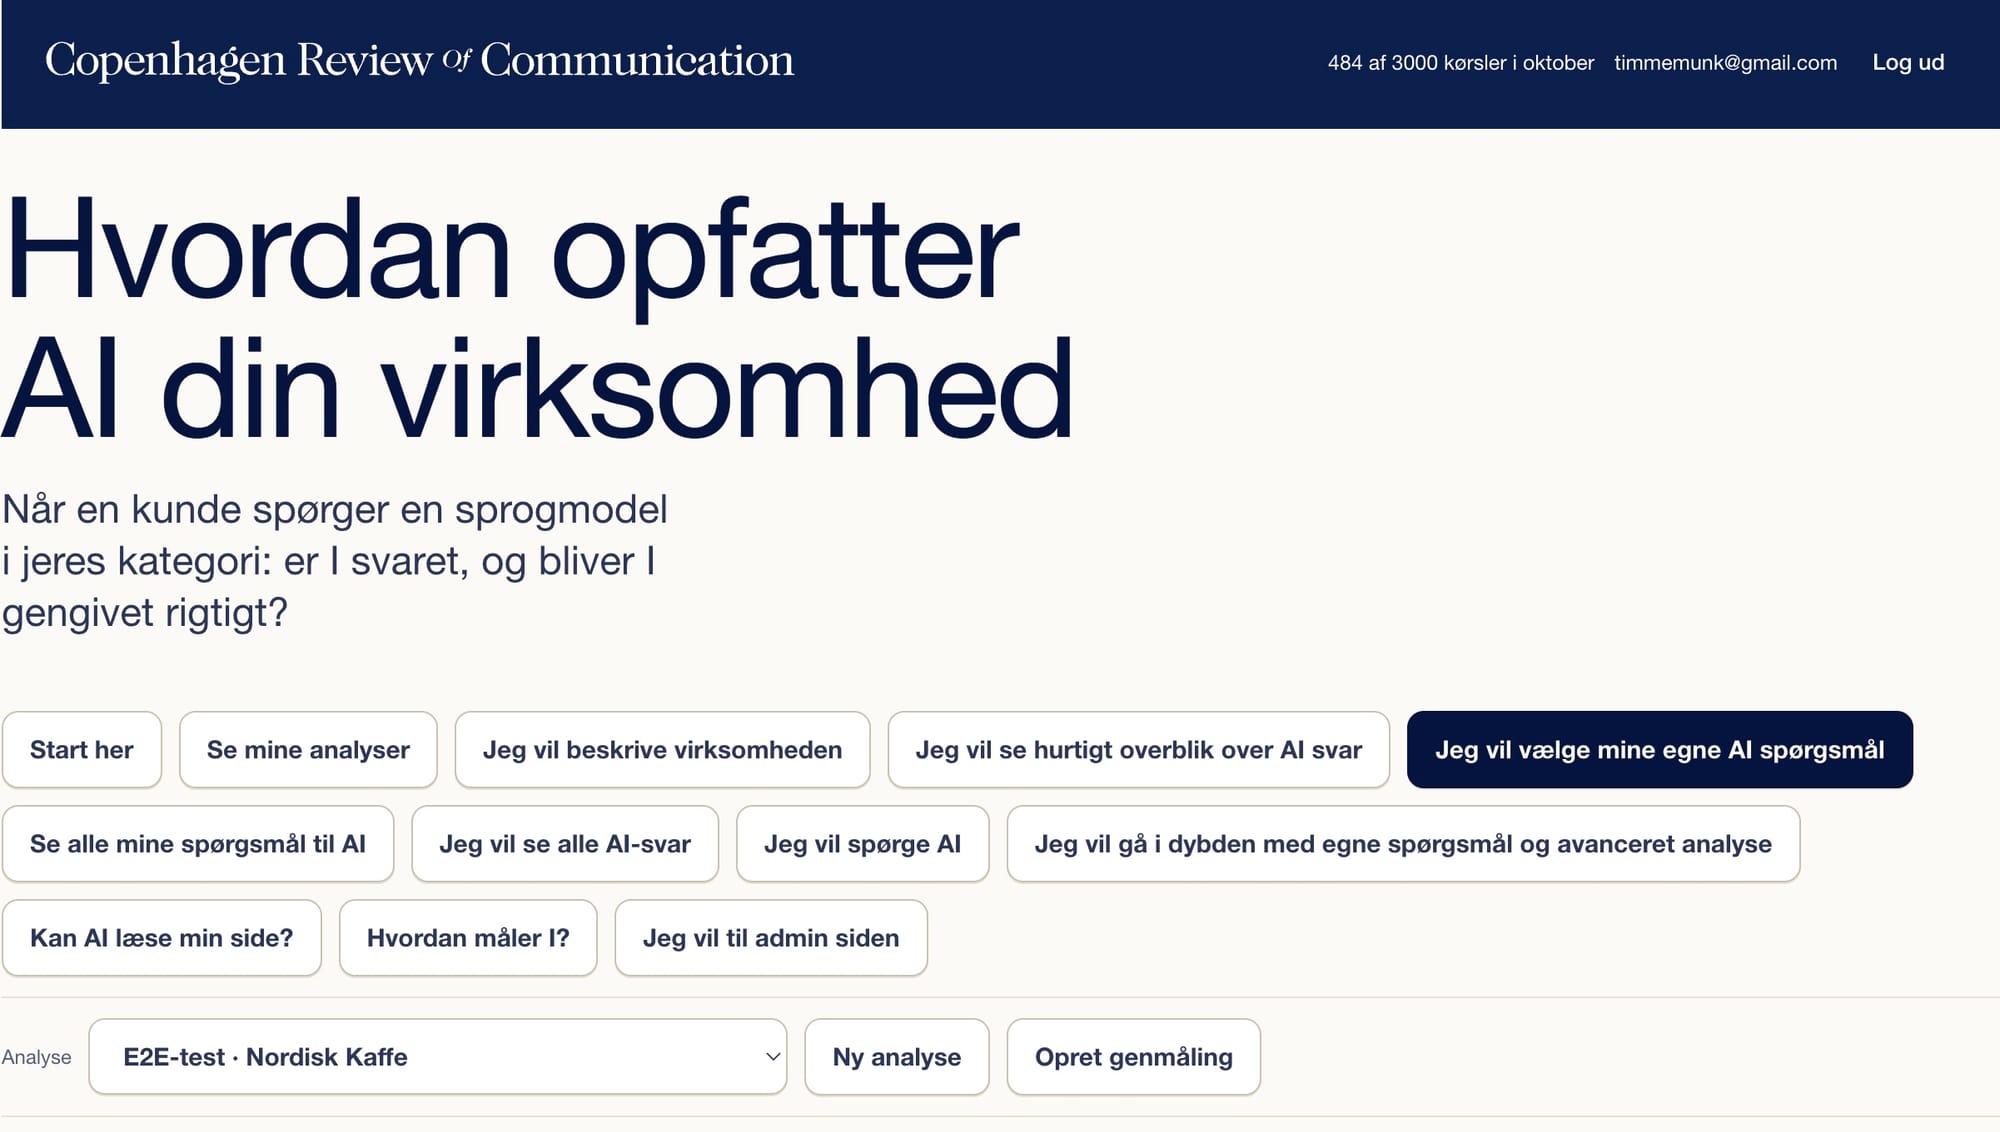
Kontrolpanelet. Hver knap svarer til noget, man selv ville spørge om, fra "Kan AI læse min side?" til avanceret analyse med egne spørgsmål. Øverst tæller kvoten: 484 af 3000 kørsler brugt i oktober. Den valgte analyse er en testkørsel på Nordisk Kaffe.
Ingen af os kan kode
Ingen af os, der har bygget værktøjet, er programmører. Vi har beskrevet i almindeligt sprog, hvad det skulle kunne. Lovable har skrevet koden. Vi har prøvet det af, kasseret, justeret og kørt igen, til det virkede.
Det kaldes vibe coding. Ordet kommer fra AI forskeren Andrej Karpathy, som i februar 2025 beskrev en måde at programmere på, hvor man giver sig hen til fornemmelsen og nærmest glemmer, at koden findes. Programmøren bliver smagsdommer.
For kommunikationsfaget er det mere end et smart trick. Vi tabte SEO, fordi det endte som et spørgsmål om kode og struktur, og koden lå hos IT. Vi leverede indholdet. IT ejede målingen og dermed æren. GEO er vores hjemmebane: indhold, kilder, omtale, troværdighed. Men man kan ikke eje et felt, man ikke selv kan måle. Kan vi ikke bygge vores egne værktøjer, bliver vi kunder hos dem, der kan. Så taber vi GEO på præcis samme måde, som vi tabte SEO.
Vibe coding fjerner den barriere. Det kræver ikke en uddannelse i programmering at bygge et værktøj, der sender seks spørgsmål til fire sprogmodeller og tæller, hvem der bliver nævnt. Det kræver, at man ved, hvilke spørgsmål der er værd at stille. Det ved kommunikatører bedre end de fleste.
Sådan bygger du dit eget
Du behøver ikke kunne kode for at få dit eget. Vi har samlet hele værktøjet i én kravspecifikation: siderne, spørgsmålene, beregningerne, rapporterne, eksporten og sikkerheden. Den er skrevet, så du kan kopiere den direkte ind som byggeopgave i Lovable eller Claude Code. Så bygger de værktøjet for dig.
Specifikationen indeholder ingen af vores data, brugere eller API nøgler. Du skal selv indsætte nøgler til ChatGPT, Claude, Gemini og Perplexity, og du betaler selv for kaldene hos udbyderne. Har du adgang til projektet i Lovable, kan du også remixe det. Så får du en kopi af koden og designet med din egen tomme database.
Vælg kategoriordet med omhu. Skriv konkurrenterne ind, som folk faktisk omtaler dem. Og kør hvert spørgsmål mere end én gang, før du konkluderer noget.
Kravspecifikationen ligger her: https://drive.google.com/file/d/1o_FsG85ziHYwWx-DLtbFWkMcTn3B1a9a/view?usp=sharing
Første test: Vi findes kun, hvis du kender os
Vi prøvede selvfølgelig værktøjet på os selv først. Den første analyse kørte på syv varianter: Claude, Gemini og ChatGPT både med og uden søgning, plus Perplexity.
læs analyserne her:


Resultatet var ret entydigt. Når navnet Copenhagen Review of Communication stod i spørgsmålet, blev vi nævnt, som regel som det første. Modellerne med søgning fandt hjemmesiden og gengav den præcist. Flere af dem gentog næsten ordret vores egen beskrivelse af et uafhængigt tidsskrift om kommunikation, viden og offentlig samtale. Grundlæggerne og deres tilknytning til Københavns Universitet kom korrekt med næsten hver gang. Det samme gjorde nyhedsbrevet og Copenhagen Preview 2027.
Uden søgning så det anderledes ud. Claude svarede gang på gang, at den ikke kendte noget tidsskrift med det navn, og foreslog Nordicom Review, MedieKultur og Journal of Communication i stedet. Gemini gættede. Nogle gange på et universitetsforankret nichetidsskrift, andre gange slet ikke.
"Jeg kender ikke et tidsskrift eller en publikation med præcis det navn." Claude uden søgning, om Copenhagen Review of Communication
Det er egentlig det vigtigste fund. Vi er ikke en del af modellernes hukommelse. Vi eksisterer kun, når modellen vælger at søge.
Og når spørgsmålet ikke nævnte os, var vi væk. Hvilket medie skal jeg vælge? Hvilket nichemedie er bedst til kommunikation, tech og kultur? Hvad er gode alternativer til MediaWatch? Svarene pegede på DR, TV 2, Politiken, Berlingske, Kforum, MediaWatch, Journalisten, Markedsføring.dk, Medietrends og Zetland. Os nævnte ingen. Heller ikke i nichespørgsmålet, som næsten er vores egen oneliner.
Anden test: Nul ud af seksten
Den 26. oktober målte vi igen. Seks spørgsmål, fire motorer med søgning, 24 svar i alt. Denne gang sorterede vi svarene efter fem niveauer af synlighed, fra det svageste til det stærkeste.
Grounded betyder, at modellen har læst ens site uden at sige det. Det skete én gang. ChatGPT slog vores side op, da den skulle svare på nichespørgsmålet, og anbefalede så Kforum, Medietrends, TechSavvy og Kulturmonitor. Den læste os og valgte nogle andre. Det er næsten værre end ikke at blive læst.
Nævnt opnåede vi i 0 af 16 spontane svar. I de 8 svar, hvor navnet stod i spørgsmålet, blev vi nævnt hver gang og fik førstepladsen.
Citeret med link til vores om os side fik vi hos ChatGPT, Claude og Gemini, men kun når de blev spurgt direkte. Perplexity nævnte os korrekt, men gav ingen klikbare links. Svarteksten havde kildemarkører som "[web:4]", der ikke førte nogen steder hen.
Anbefalet blev vi ikke. I sammenligningen med MediaWatch svarede modellerne afbalanceret: vælg CRC, hvis du vil have faglig dybde, vælg MediaWatch, hvis du vil have branchenyheder. Det er pænt. Men det er ikke en anbefaling.
Henvist, altså om folk faktisk klikker sig over til os fra en AI, kan ikke måles via API. Det kræver vores egen webanalyse.
En detalje skal med. Spørgsmålet "Hvilken medie skal jeg vælge i Danmark?" blev af Gemini og Perplexity i to tilfælde læst som et spørgsmål om et clairvoyant medium. Det er sjovt. Det er også en lektie: det kategoriord, man skriver ind i værktøjet, styrer hele målingen. "Medie" var et dårligt valg. "Fagmedie om kommunikation" havde været bedre. Og grammatikken i "hvilken medie" står vi selv for.
Hvad SWOT'en viste
Vi har lagt de to analyser sammen.
Styrker
Når folk kender navnet, får de et retvisende billede. Tre af fire motorer beskrev os ens og korrekt, med stiftere, startdato i oktober 2024, nyhedsbrev, jobannoncer og konferencen på Nørrebro Teater. Det tyder på, at om os siden er let at finde og let at læse for en maskine. I sammenligningen med MediaWatch blev vi placeret som det faglige og refleksive alternativ til et branchemedie. Det er den position, vi selv går efter.
Svagheder
Vi er usynlige for alle, der ikke allerede kender os. Ingen spontane omtaler i nogen af de to målinger. Modeller uden søgning ved ikke, vi findes. Og flere svar bemærkede, at der ikke er offentlige tal for vores læsere eller abonnenter. Det svækker os, når en model skal vælge mellem os og et medie med dokumenteret rækkevidde.
Muligheder
Kategorien findes allerede i modellernes verden. Når de svarer på nichespørgsmålet, nævner de Kforum, Medietrends og Zetland. Pladsen er der. Den bliver ikke vores af sig selv. Modellerne trækker tydeligvis på oversigtsartikler, hvor danske fagmedier sammenlignes, fx på kempkjaer.dk og i oversigter fra SDU. Kommer vi med i den slags tekster, kommer vi formentlig med i svarene.
Trusler
Kforum er den konkurrent, modellerne oftest bruger som målestok. Et svar kaldte Kforum det stærkeste danske match. MediaWatch og Kforum blev nævnt i 9 af 24 svar, vi i 8, og alle vores 8 kom fra spørgsmål, hvor vores navn allerede stod. Hvis det mønster holder, bliver nye læsere ved med at blive sendt til de andre. Perplexitys manglende links betyder, at selv en korrekt omtale ikke nødvendigvis giver et besøg.
Bundlinjen
Vi lærte mere af at bygge værktøjet end af at læse om GEO. Det vigtigste fund er ubehageligt enkelt: modellerne kender os ikke. De finder os, når nogen allerede leder efter os.
Vi lærte noget andet med. Kommunikatører kan bygge deres egne værktøjer nu. Vi overlod SEO til IT, fordi vi ikke kunne kode. Den undskyldning er væk nu. Fremtiden begynder med, at vi selv stiller spørgsmålene og selv bygger maskinen, der skal svare på dem.


